Use a API do Firecrawl por meio do Model Context Protocol
Uma implementação de servidor do Model Context Protocol (MCP) que integra o Firecrawl para recursos de web scraping. Nosso servidor MCP é de código aberto e está disponível no GitHub.
Configurando o Cursor 🖥️
Observação: requer o Cursor na versão 0.45.6 ou superior.
Para obter as instruções de configuração mais atualizadas, consulte a documentação oficial do Cursor sobre como configurar servidores MCP:
Guia de configuração de servidor MCP do CursorPara configurar o Firecrawl MCP no Cursor v0.48.6
Se você estiver no Windows e tiver problemas, tente cmd /c "set FIRECRAWL_API_KEY=your-api-key && npx -y firecrawl-mcp"
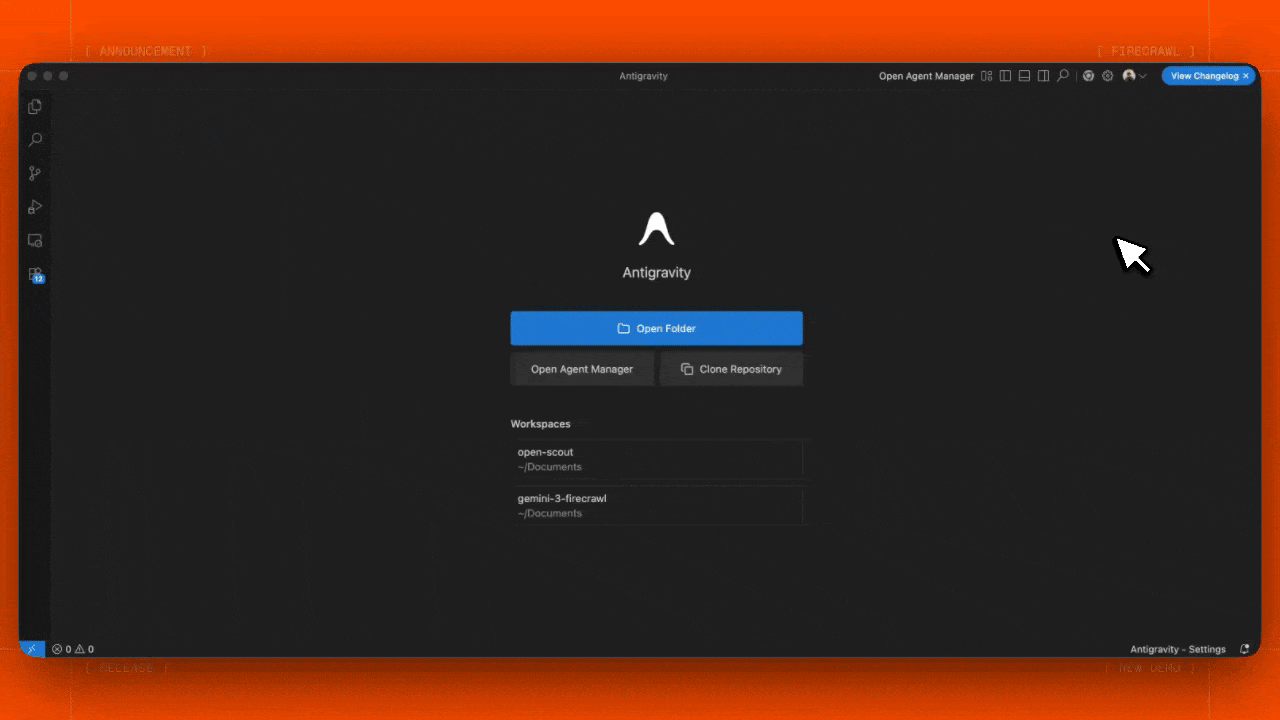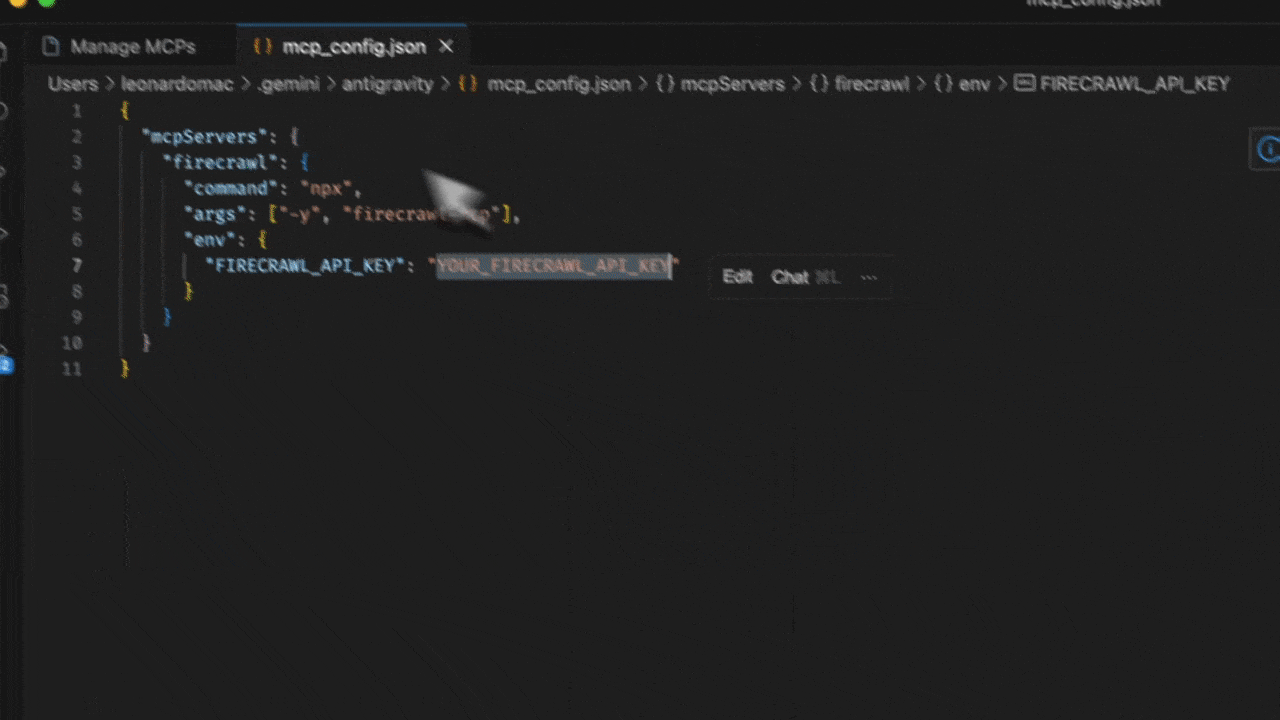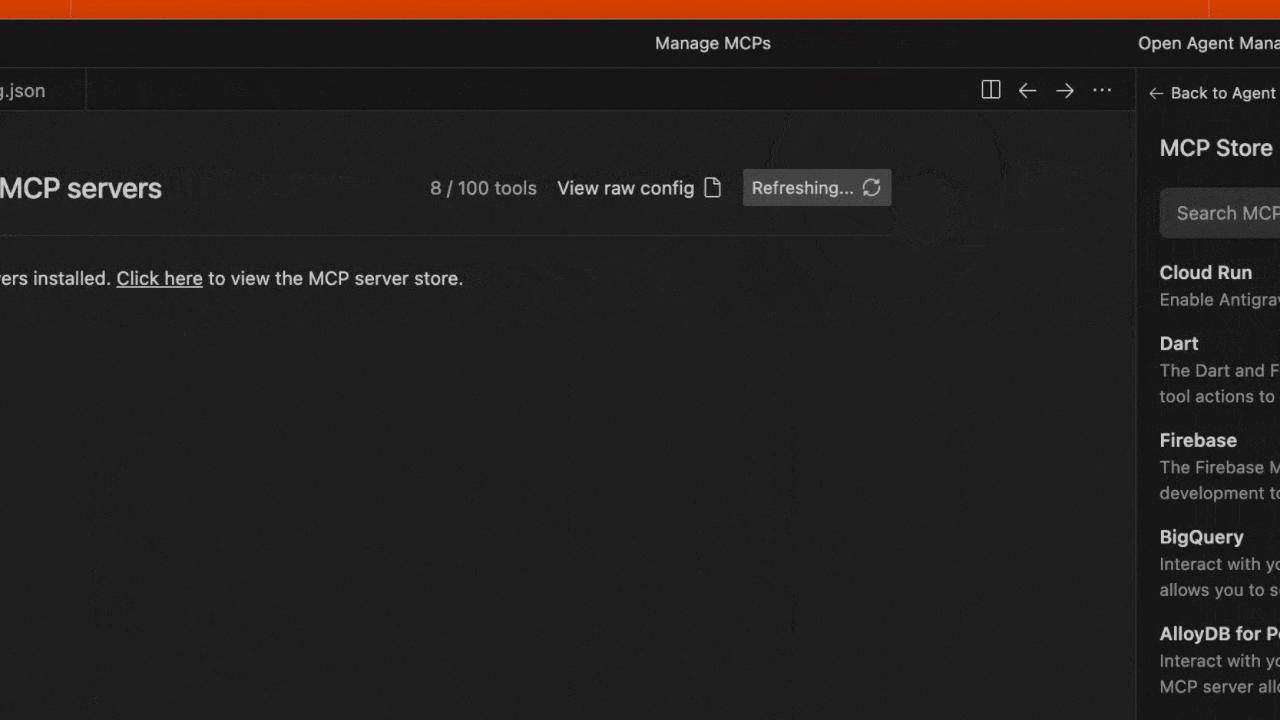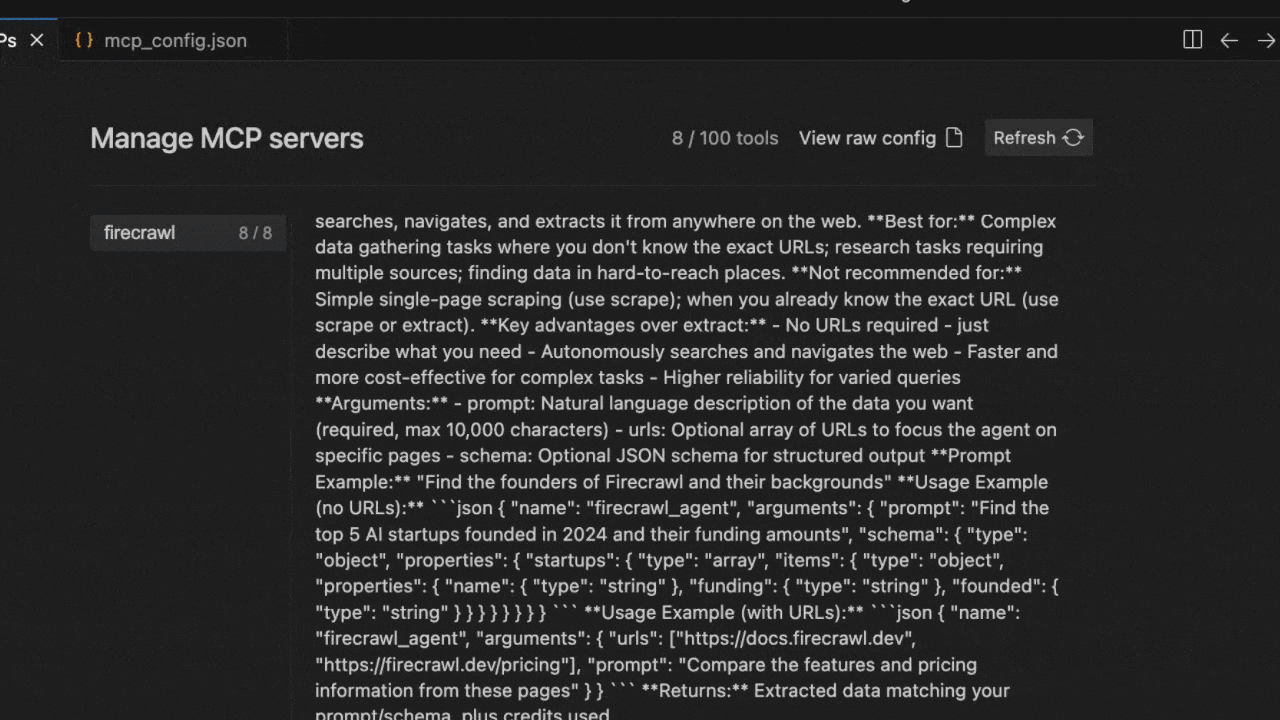
Substitua your-api-key pela sua chave de API do Firecrawl. Se você ainda não tiver uma, crie uma conta e obtenha-a em https://www.firecrawl.dev/app/api-keysApós adicionar, atualize a lista de servidores MCP para ver as novas ferramentas. O Composer Agent usará automaticamente o Firecrawl MCP quando apropriado, mas você pode solicitá-lo explicitamente descrevendo suas necessidades de web scraping. Acesse o Composer com Command+L (Mac), selecione “Agent” ao lado do botão de envio e insira sua consulta.
Para instalar com um clique, use um dos botões de instalação abaixo…Para instalação manual, adicione o seguinte bloco JSON ao arquivo User Settings (JSON) no VS Code. Você pode fazer isso pressionando Ctrl + Shift + P e digitando Preferences: Open User Settings (JSON).
Opcionalmente, você também pode adicioná-lo a um arquivo chamado .vscode/mcp.json no seu espaço de trabalho. Isso permitirá que você compartilhe essa configuração com outras pessoas:
Nota: Alguns usuários relataram problemas ao adicionar o servidor MCP ao VS Code devido à forma como ele valida JSON com um formato de schema desatualizado (microsoft/vscode#155379).
Isso afeta várias ferramentas MCP, incluindo Firecrawl.Solução alternativa: Desative a validação de JSON no VS Code para permitir que o servidor MCP seja carregado corretamente.
Consulte a referência: directus/directus#25906 (comment).O servidor MCP continua funcionando normalmente quando invocado por outras extensões, mas o problema ocorre especificamente ao registrá-lo diretamente na lista de servidores MCP. Planejamos adicionar orientações assim que o VS Code atualizar a validação de schema.
Em Tools to include, você pode selecionar All, Selected ou All Except – isso expõe as ferramentas do Firecrawl (scrape, crawl, map, search, extract, etc.)
Para implantações autohospedadas, execute o servidor MCP com npx e habilite o modo de transporte HTTP:
Isso iniciará o servidor em http://localhost:3000/v2/mcp, que você pode usar no seu workflow do n8n como endpoint. A variável de ambiente HTTP_STREAMABLE_SERVER=true é obrigatória, já que o n8n precisa de transporte HTTP.
Para uso da API em nuvem com tentativas personalizadas e monitoramento de créditos:
# Necessário para a API em nuvemexport FIRECRAWL_API_KEY=your-api-key# Configuração opcional de tentativasexport FIRECRAWL_RETRY_MAX_ATTEMPTS=5 # Aumentar o número máximo de tentativasexport FIRECRAWL_RETRY_INITIAL_DELAY=2000 # Começar com atraso de 2sexport FIRECRAWL_RETRY_MAX_DELAY=30000 # Atraso máximo de 30sexport FIRECRAWL_RETRY_BACKOFF_FACTOR=3 # Backoff mais agressivo# Monitoramento opcional de créditosexport FIRECRAWL_CREDIT_WARNING_THRESHOLD=2000 # Aviso a partir de 2000 créditosexport FIRECRAWL_CREDIT_CRITICAL_THRESHOLD=500 # Crítico a partir de 500 créditos
Para instâncias auto-hospedadas:
# Necessário para auto-hospedadoexport FIRECRAWL_API_URL=https://firecrawl.seu-dominio.com# Autenticação opcional para auto-hospedadoexport FIRECRAWL_API_KEY=sua-api-key # Se sua instância exigir autenticação# Configuração personalizada de novas tentativasexport FIRECRAWL_RETRY_MAX_ATTEMPTS=10export FIRECRAWL_RETRY_INITIAL_DELAY=500 # Comece com novas tentativas mais rápidas
O servidor inclui vários parâmetros configuráveis que podem ser definidos por meio de variáveis de ambiente. A seguir estão os valores padrão caso não sejam configurados:
const CONFIG = { retry: { maxAttempts: 3, // Number of retry attempts for rate-limited requests initialDelay: 1000, // Initial delay before first retry (in milliseconds) maxDelay: 10000, // Maximum delay between retries (in milliseconds) backoffFactor: 2, // Multiplier for exponential backoff }, credit: { warningThreshold: 1000, // Warn when credit usage reaches this level criticalThreshold: 100, // Alerta crítico quando o uso de créditos atingir este nível },};
Essas configurações controlam:
Comportamento de tentativas (retries)
Tenta novamente automaticamente as requisições que falharam devido a limites de taxa
Usa backoff exponencial para evitar sobrecarregar a API
Exemplo: com as configurações padrão, as novas tentativas serão feitas em:
1ª tentativa: atraso de 1 segundo
2ª tentativa: atraso de 2 segundos
3ª tentativa: atraso de 4 segundos (limitado por maxDelay)
Monitoramento do uso de créditos
Acompanha o consumo de créditos da API para uso em nuvem
Fornece avisos em limites definidos
Ajuda a evitar interrupções inesperadas do serviço
search: Termo de pesquisa opcional para filtrar URLs
sitemap: Controla o uso do sitemap — “include”, “skip” ou “only”
includeSubdomains: Se deve incluir subdomínios no mapeamento
limit: Número máximo de URLs a serem retornadas
ignoreQueryParameters: Se deve ignorar parâmetros de consulta ao mapear
Ideal para: Descobrir URLs em um site antes de decidir o que extrair; encontrar seções específicas de um site.
Retorna: Array de URLs encontradas no site.
Agente autônomo de pesquisa na web que navega independentemente pela internet, busca informações, percorre páginas e extrai dados estruturados com base na sua consulta. Esse agente é executado de forma assíncrona — ele retorna imediatamente um ID de job, e você faz polling em firecrawl_agent_status para verificar quando for concluído e recuperar os resultados.
{ "name": "firecrawl_agent", "arguments": { "prompt": "Find the top 5 AI startups founded in 2024 and their funding amounts", "schema": { "type": "object", "properties": { "startups": { "type": "array", "items": { "type": "object", "properties": { "name": { "type": "string" }, "funding": { "type": "string" }, "founded": { "type": "string" } } } } } } }}
Você também pode fornecer URLs específicas nas quais o agente deve se concentrar:
{ "name": "firecrawl_agent", "arguments": { "urls": ["https://docs.firecrawl.dev", "https://firecrawl.dev/pricing"], "prompt": "Compare the features and pricing information from these pages" }}
prompt: Descrição em linguagem natural dos dados que você quer (obrigatório, máx. 10.000 caracteres)
urls: Array opcional de URLs para focar o agente em páginas específicas
schema: Esquema JSON opcional para saída estruturada
Melhor para: Tarefas de pesquisa complexas quando você não sabe as URLs exatas; coleta de dados de múltiplas fontes; encontrar informações espalhadas pela web; extrair dados de SPAs pesadas em JavaScript que falham com a raspagem comum.Retorna: ID do job para verificação de status. Use firecrawl_agent_status para consultar os resultados periodicamente.
8. Verificar status do agente (firecrawl_agent_status)
Verifique o status de uma tarefa do agente e recupere os resultados quando ela for concluída. Faça verificações (polling) a cada 15–30 segundos e mantenha por pelo menos 2–3 minutos antes de considerar a solicitação como falha.
ttl: Tempo de vida total da sessão em segundos (30-3600, opcional)
activityTtl: Tempo limite de inatividade em segundos (10-3600, opcional)
Melhor para: Executar código (Python/JS) que interage com uma página de navegador em tempo real, automação de navegador em várias etapas, sessões com perfis que persistem entre múltiplas chamadas de ferramenta.Retorna: ID da sessão, URL do CDP e URL de visualização em tempo real.
[INFO] Firecrawl MCP Server initialized successfully[INFO] Starting scrape for URL: https://example.com[INFO] Starting crawl for URL: https://example.com[WARNING] Credit usage has reached warning threshold[ERROR] Limite de requisições excedido, tentando novamente em 2s...

 Para instalação manual, adicione o seguinte bloco JSON ao arquivo User Settings (JSON) no VS Code. Você pode fazer isso pressionando